- Lee
- CSV, JSON, Parquet, Feather, Excel, SQL
- Python
- 3.10 a 3.14
- Reglas por defecto
- 20
- Tests
- 747 al 99%
- Licencia
- Apache 2.0
El código tiene SemVer. Los datos no.
Una columna eliminada, un teléfono que se convirtió en cadena, una distribución que se
desplazó en silencio. Todo eso rompe a quien está aguas abajo. Y todo eso suele
publicarse como «se actualizó el dataset».
DataSemver hace ese impacto explícito y revisable, para que publicar un dataset se pueda
discutir como se discute publicar una librería.
Cómo decide
Cada diferencia se contrasta contra una regla, y cada regla lleva una severidad. La
severidad más alta encontrada se convierte en el salto, y por eso el orden de abajo es
el argumento entero y no una forma de agrupar tres tarjetas.
major1.4.2 → 2.0.0
Las consultas existentes pueden romperse
Algo de lo que ya dependen los consumidores ha desaparecido, o ahora significa otra cosa.
- column_removed
- type_changed_incompatible
- column_renamed
- distribution_shift
- psi_greater_than
minor1.4.2 → 1.5.0
Información nueva, los contratos se mantienen
Hay más de lo que había, y nada de lo que estaba se ha movido.
- column_added
- row_count_increased
- new_category_added
- cardinality_changed
- category_balance_shift
- rows_modified
patch1.4.2 → 1.4.3
El mismo significado, mejores datos
El dataset dice lo que ya decía, con menos huecos o menos ruido.
- nulls_fixed
- minor_stat_change
- type_changed_compatible
La severidad es de tu fichero de reglas, no del cambio en sí. Las reglas por defecto son
una opinión; a su lado viajan
perfiles estricto y permisivo,
y el catálogo de reglas
(en inglés) lista cada regla, métrica y umbral. Lo que ninguna regla cubre se reporta
como no clasificado y nunca infla el resultado.
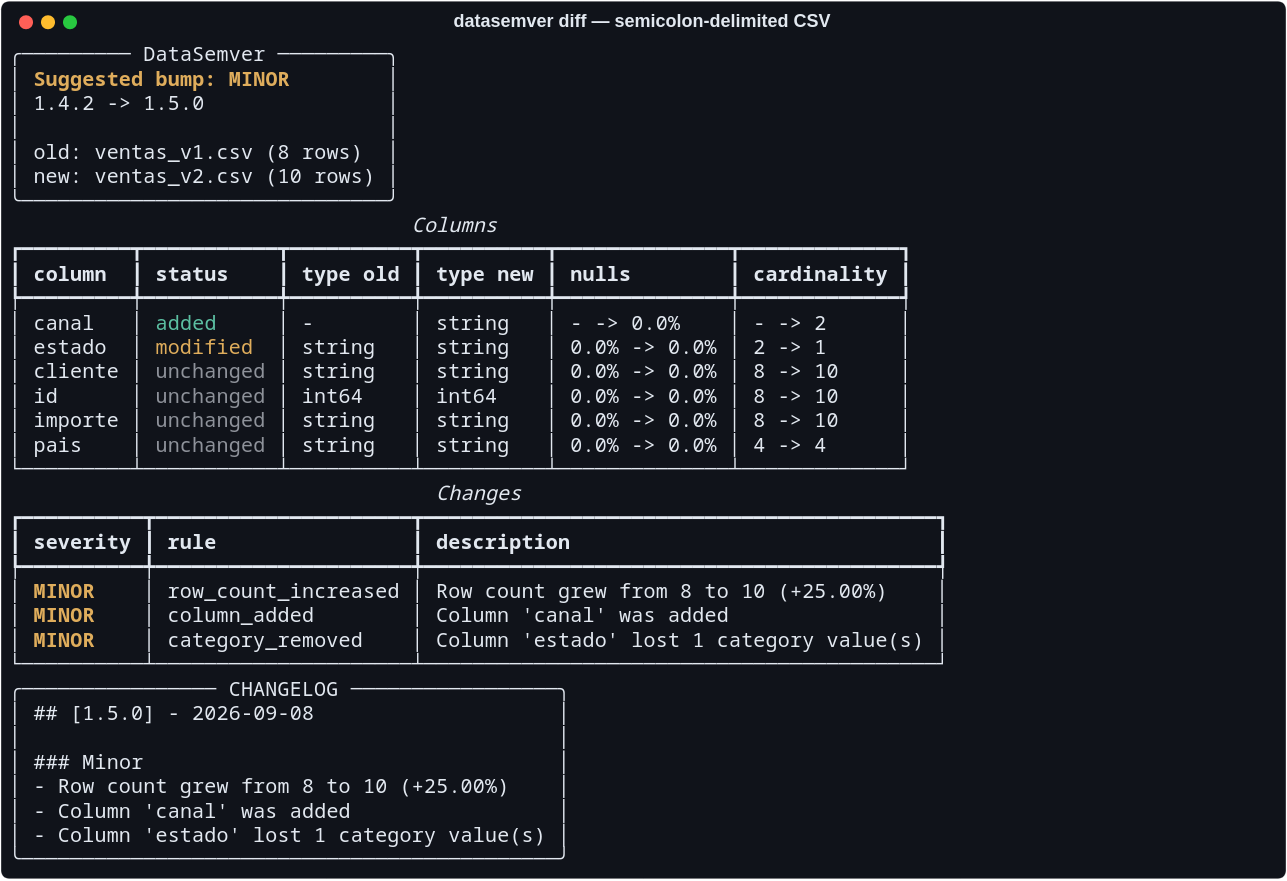
El delimitador se detecta, no se supone
Esta exportación separa sus campos con punto y coma mientras cada importe lleva
además una coma. La coma nunca llega a la cabecera, así que gana el punto y coma y el
fichero se carga como cinco columnas en lugar de una.
Se reconocen coma, punto y coma, tabulador y barra vertical. Define
DATASEMVER_CSV_DELIMITER para saltarte la detección por completo.
Qué lee
Un solo comando venga como venga el dataset, porque el formato rara vez es lo que se está
comparando. Un perfil guardado cuenta como dataset en cualquiera de los dos lados, así que
una comparación puede correr con la versión anterior ya desaparecida.
Texto
CSV y TSV, comprimidos o no, con el delimitador detectado. JSON como array de objetos, y JSON Lines.
.csv .tsv .csv.gz .tsv.gz .json .jsonl .ndjson
Arrow en disco
Parquet y Feather declaran el tipo de cada columna, así que no se infiere nada: un código postal sigue siendo texto en vez de convertirse en un entero sin el cero inicial.
.parquet .pq .feather .arrow
Libros de Excel
Una hoja tras #, o la primera cuando no se nombra ninguna. Necesita el extra excel.
quarterly.xlsx#Q3
Tablas de base de datos
Una URL de conexión con la tabla tras #. La contraseña no llega nunca al informe, a los logs ni al nombre de un fichero.
sqlite:///snapshots.db#customers
El mismo análisis en el navegador
El panel es un cliente de la librería, no una copia bifurcada. Llama a la misma función y
pinta el mismo informe, así que los dos coinciden por construcción.
127.0.0.1:8000
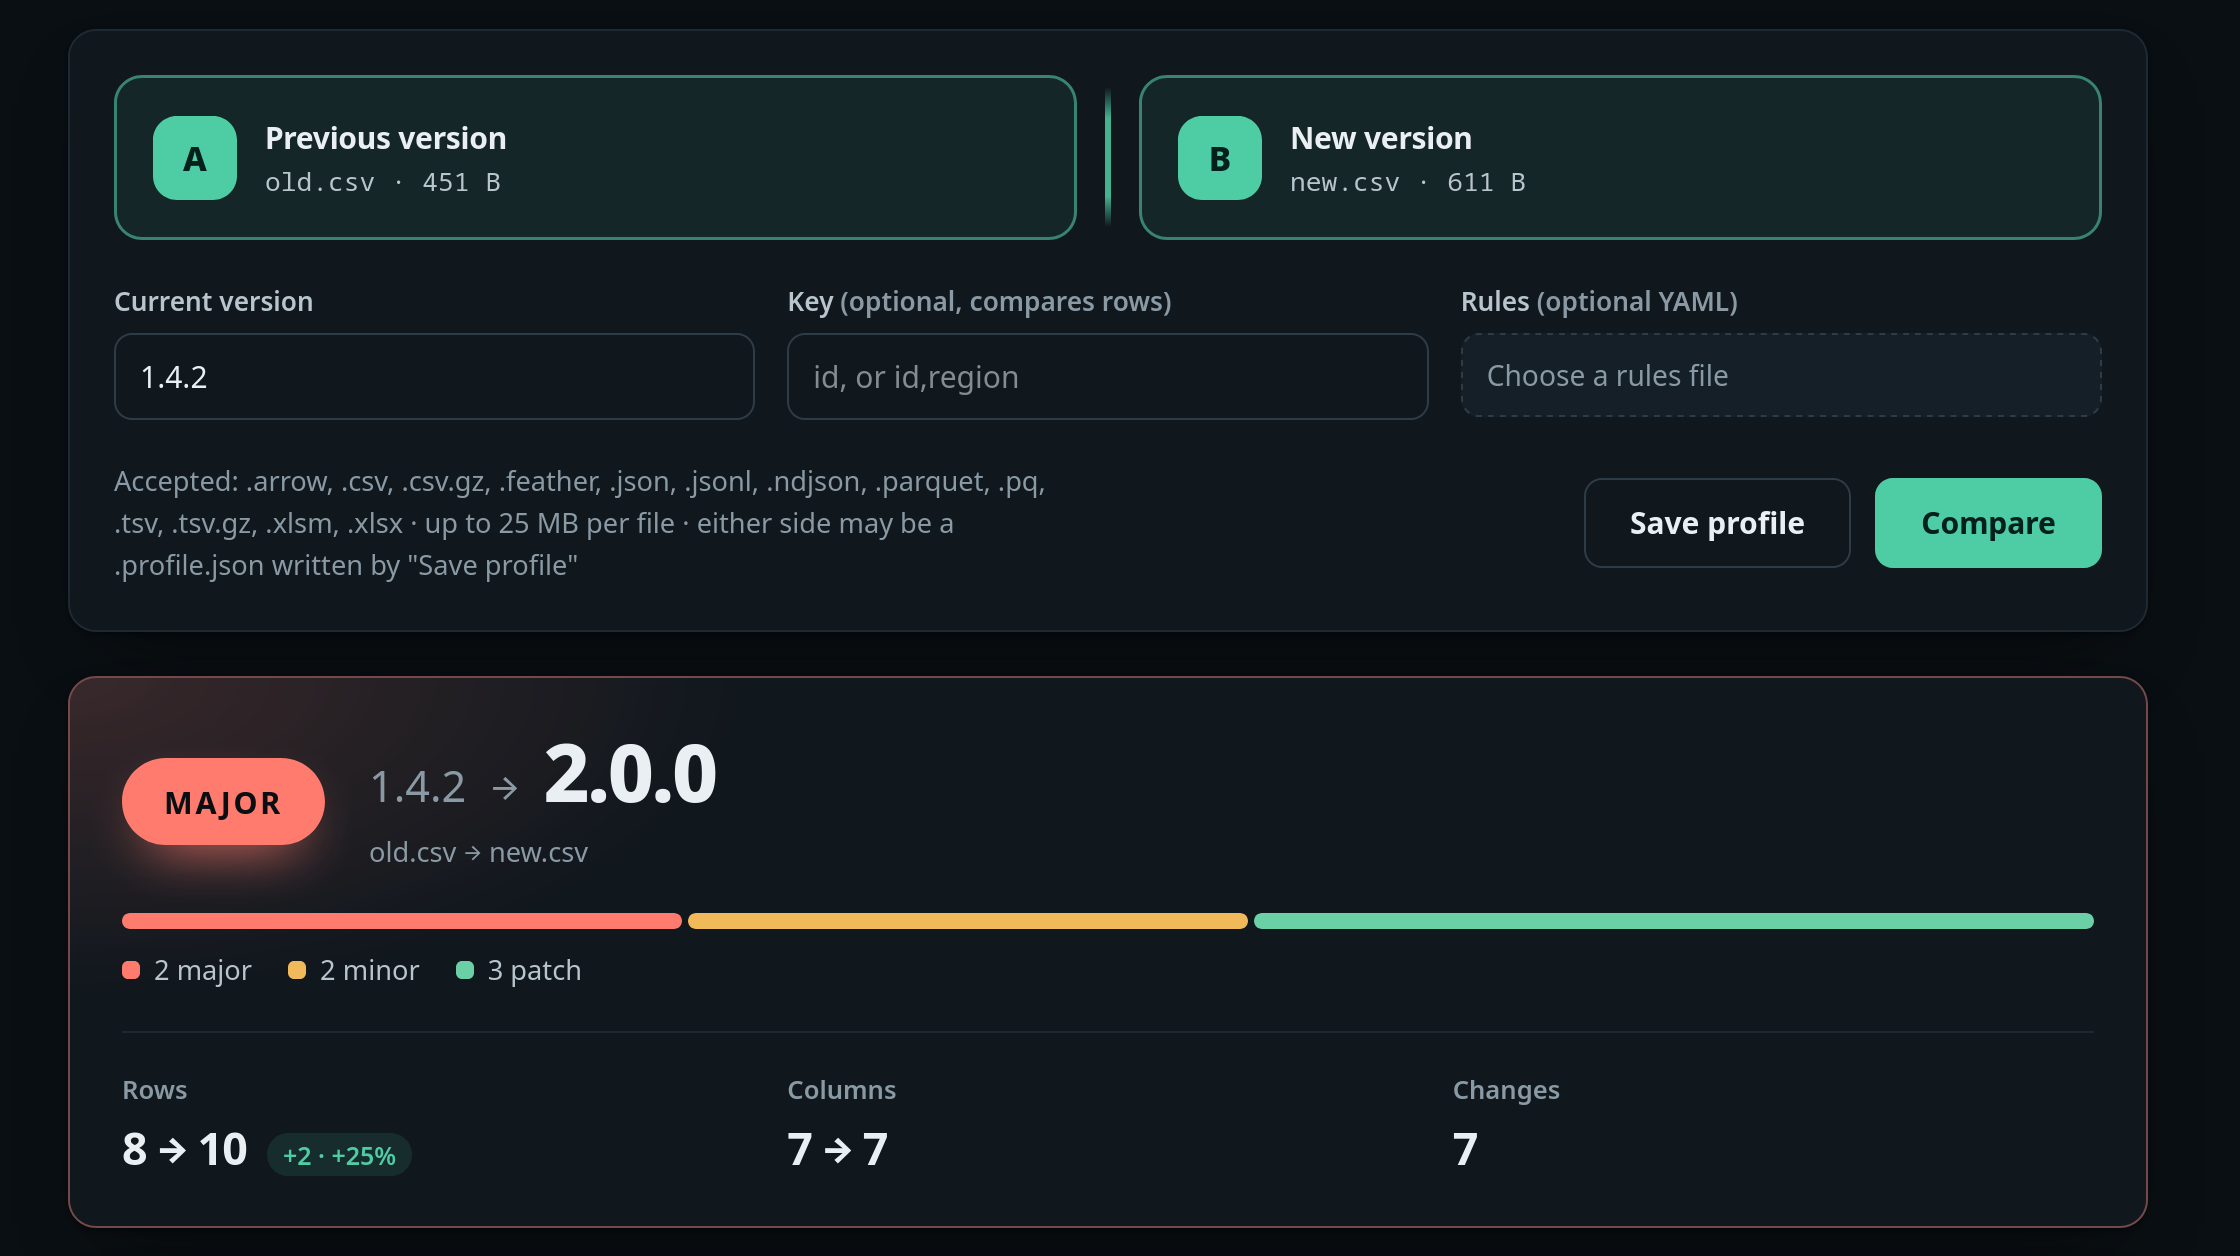
Sube dos ficheros, o elige dos versiones de un directorio que vigile.
Compara distribuciones, no solo esquemas
Una media es un punto de una distribución, y una columna puede reconstruirse a su
alrededor sin moverla. Tres cambios que rompen a cualquier consumidor aguas abajo, y que
una comparación de esquemas y promedios reporta como nada en absoluto:
Una forma, no un centro
La dispersión se multiplica por cuarenta y la media no se mueve. Se mide con un estadístico de Kolmogorov-Smirnov sobre una rejilla de cuantiles guardada.
std 0.998 → 39.96
Un balance, no un conjunto
Una etiqueta pasa de equilibrada a una entre cien con ambos valores todavía presentes, así que el conjunto de categorías no cambia. Se mide con el Population Stability Index.
'ok' 50.3% → 99.0%
Una ventana en el tiempo
Una columna de fecha se compara por dónde se sitúa de verdad, así que un export que se ha deslizado o que ahora cubre medio periodo es un cambio y no un silencio.
2020-01-01 → 2026-01-01
Ambas se pesan contra lo que la muestra puede sostener. Un estadístico KS no tiene una
lectura fija: con cuatro filas contra cinco, añadir una sola mueve la distribución un
quinto, así que un desplazamiento tiene que superar el valor crítico para esos tamaños
además del umbral configurado. Con un puñado de filas no se reporta nada, porque no hay
nada que reportar. Y con --key las filas se emparejan en lugar de resumirse:
una versión donde se ha reescrito un tercio de ellas con valores de la misma distribución
tiene el mismo perfil que la anterior, y es un dataset distinto para quien haga un join.
Perfila un fichero mayor que la memoria
El motor por defecto carga el dataset en un dataframe, que es lo más rápido hasta que el
dataset deja de caber. --engine duckdb agrega sobre el fichero en su lugar, y
duckdb-sketch estima la rejilla de cuantiles en vez de calcularla — el
único número que cuesta una pasada entera.
Medido sobre 16 millones de filas y siete columnas, en pico de memoria residente del
proceso. El sketch es un motor con nombre propio y no un atajo automático, porque deja de
interpolar entre valores en entradas pequeñas: sobre ocho filas responde 1 donde el otro
camino responde 1,35, así que diverge más justo donde el resultado es más fácil de
comprobar a mano. Fija DATASEMVER_DUCKDB_MEMORY_LIMIT y el techo es tuyo; lo
que no quepa se vuelca a disco en lugar de fallar.
# la mitad de memoria, las mismas respuestas
datasemver diff old.parquet new.parquet --engine duckdb

# un tercio más, con la rejilla de cuantiles estimada
datasemver profile huge.csv --engine duckdb-sketch
El perfil sobrevive a los datos
Una comparación lee un perfil: las columnas, sus tipos, sus ratios de nulos, una rejilla
de cuantiles y los conteos por categoría. Es lo bastante pequeño para guardarlo junto al
dataset, y entonces la versión anterior no hay que descargarla nunca — ni que exista.
- Dataset
- 63,6 MB
- Su perfil
- 2,9 KB
- Ratio
- 21.916:1
# escríbelo una vez, junto a los datos
datasemver profile customers_v3.parquet

# compara contra él más adelante, con el fichero ya desaparecido
datasemver diff customers_v3.profile.json customers_v4.parquet

# desde el footer del Parquet: un seek en vez de un escaneo
datasemver profile customers_v3.parquet --schema-only
El footer de un Parquet ya guarda el esquema y, por columna, los nulos y el valor más
pequeño y el más grande — toda la entrada que lee una comparación a nivel de
esquema. Lo que no puede dar es la rejilla de cuantiles ni los conteos por categoría, así
que un perfil escrito desde ahí lo registra, y cualquier comparación contra él dice que no
se comprobó ninguna distribución. Sin eso, el informe se leería igual que uno donde nada
se movió.
Siete formas de usarlo, un informe
Línea de comandos
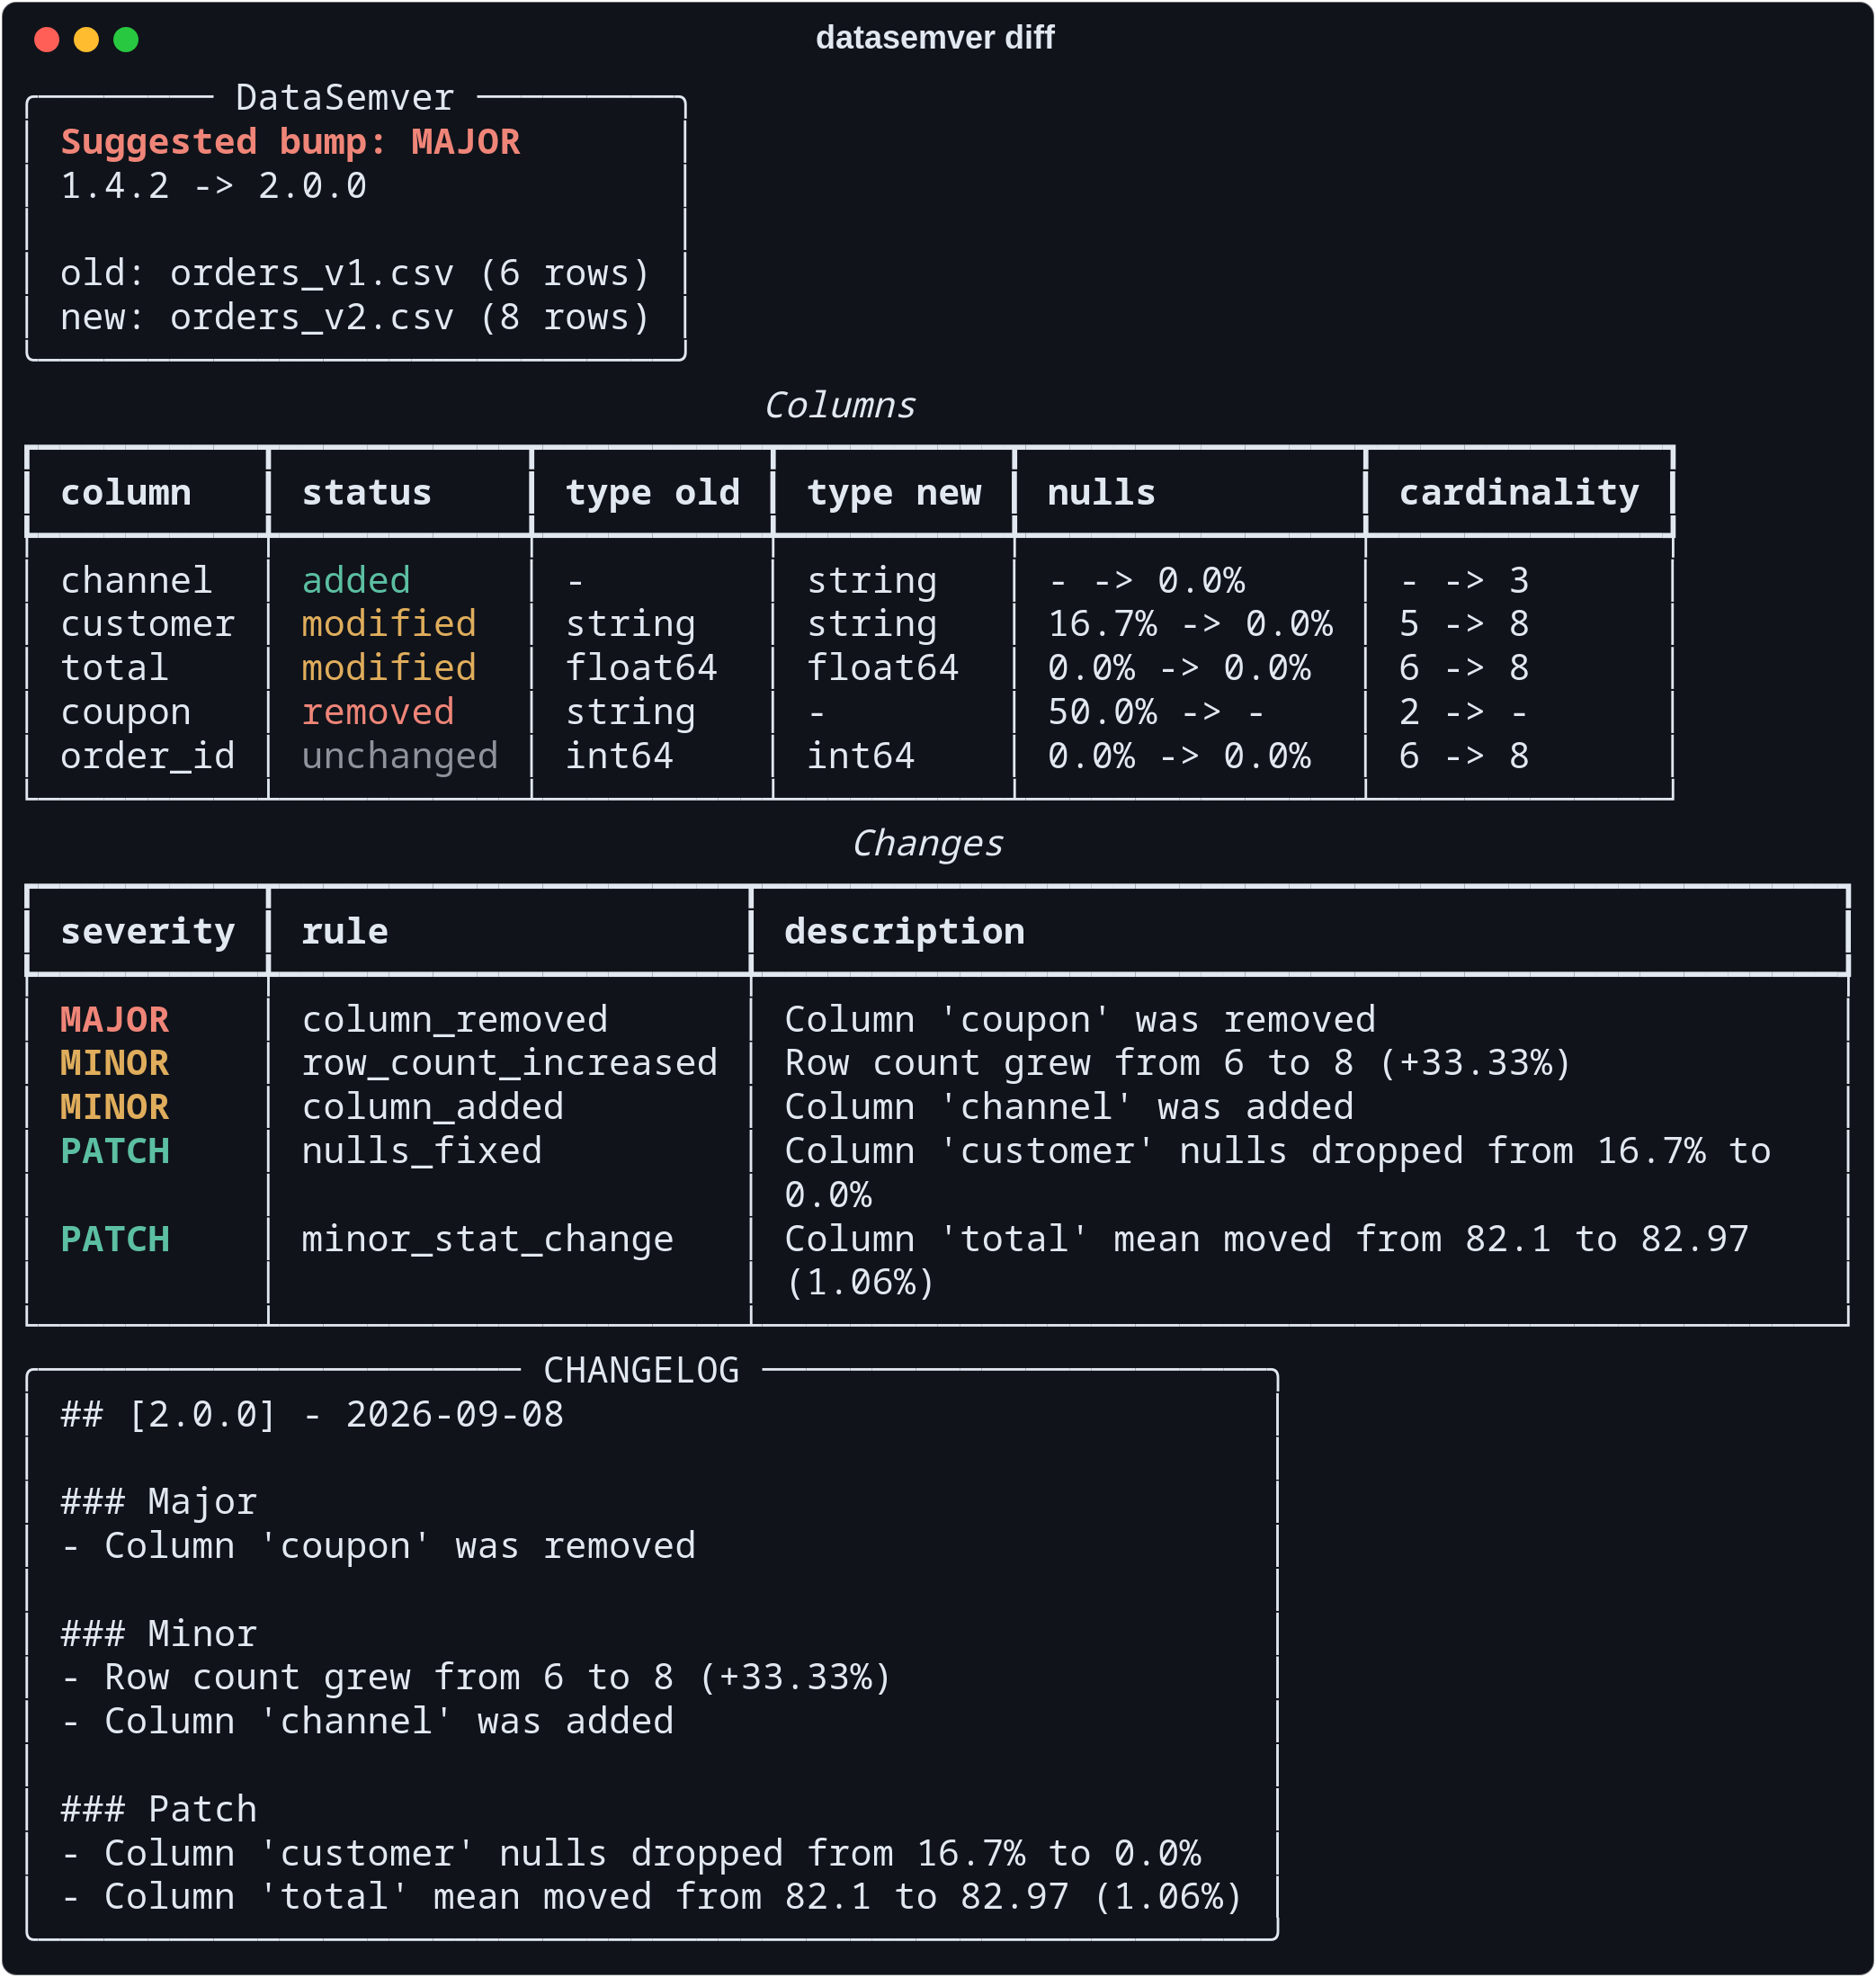
Construida sobre typer y rich. Añade --json cuando quien lee la respuesta es un script y no una persona.
datasemver diff old.csv new.csv
Tablas de base de datos
Una URL de conexión con la tabla tras #. SQLite no necesita driver; PostgreSQL y MySQL usan el extra sql.
sqlite:///snapshots.db#clientes
Librería de Python
Dos rutas, o dos perfiles que ya tengas en memoria cuando los datos vienen de una consulta al almacén.
from datasemver import analyze
Panel web
Una herramienta local, sin autenticación y sin límite de peticiones. Mantenla en la interfaz de loopback.
pip install "datasemver[web]"
GitHub Action
Analiza los datasets que toca un pull request y publica el salto sugerido, reescribiendo el mismo comentario en cada push. Define un umbral y rechaza el merge — después de comentar, para que el rechazo llegue con su motivo.
uses: IzanVil/datasemver@v0.8.2
DVC
Compara los datasets que DVC reporta como cambiados entre dos revisiones, continuando cada uno desde la versión registrada a su lado en vez de empezar de cero.
datasemver dvc --rev HEAD~1
Binario independiente
Un ejecutable por plataforma que trae su propio Python, para máquinas donde instalarlo no es una opción. El soporte de bases de datos y libros de Excel va dentro.
linux · windows · macos arm64 y x86_64
# leer el salto desde un script de release
BUMP=$(datasemver diff old.csv new.csv --json | jq -r '.bump')

# anteponer la entrada de changelog a un fichero que tú mantienes
datasemver diff old.csv new.csv --current-version "$(cat VERSION)" --output CHANGELOG.md

# rechazar un cambio que rompe: 0 salió limpio, 1 fue rechazado, 2 no pudo ejecutarse
datasemver diff old.csv new.csv --fail-on major

# qué filas cambiaron, no solo si cambió la forma
datasemver diff old.csv new.csv --key id

# registra la versión que ha calculado, en vez de teclearla otra vez
datasemver diff old.csv new.csv --current-version 1.4.2 --write-version
Instalarlo
Python 3.10 o superior, tipado y sin acceso a red en tiempo de ejecución. Las releases se
publican desde CI mediante Trusted Publishing con procedencia firmada, así que no existe
ningún token de larga duración. Los extras se piden: sql para bases de datos,
excel para libros, duckdb para los motores, web
para el panel.
¿Sin Python en la máquina? Cada release lleva además un único ejecutable por plataforma
que trae el suyo, con bases de datos y libros de Excel incluidos —
en la última release.